
CISA отказалась от жёстких сроков для уязвимостей в AI-стеке
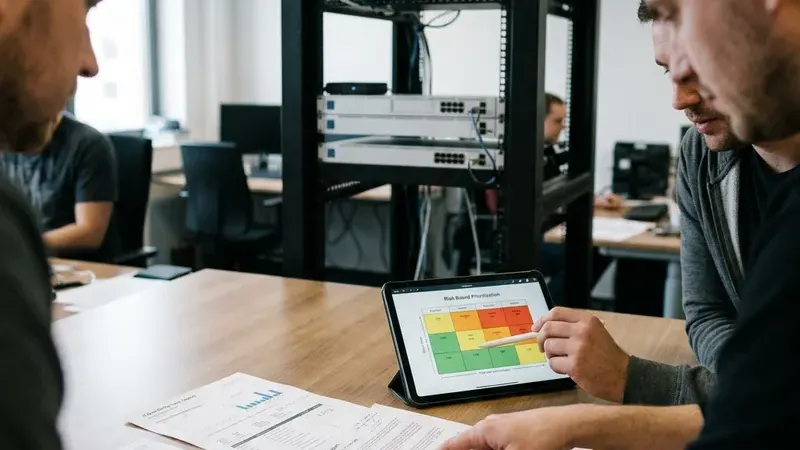
CISA пересмотрела подход к устранению уязвимостей: теперь срок предлагают считать не по общему календарю, а по риску конкретного актива. Для AI-платформ это особенно важно, потому что в разных слоях «исправить уязвимость» означает совсем разные действия — от обычного патча до замены компонента или простоя на обновление драйвера.
Почему старый SLA перестал работать
10 июня 2026 года CISA выпустила директиву BOD 26-04 Prioritizing Security Updates Based on Risk и одновременно отменила прежние документы BOD 19-02 и BOD 22-01. До этого федеральные агентства США жили по единому календарному подходу: если уязвимость попадала в Known Exploited Vulnerabilities, для неё назначался заранее заданный срок закрытия.
Новая модель меняет логику. Вместо одинакового дедлайна для всех CISA предлагает смотреть на контекст: доступен ли актив извне, есть ли запись в KEV, можно ли автоматизировать атаку и к какому техническому эффекту она приводит. В наиболее срочном случае на реакцию даётся три дня и требуется первичный forensic triage, а в менее срочном — исправление можно отнести к очередному плановому обновлению.
Почему AI-платформа — самый неудобный пример
Для обычного веб-API всё относительно просто: уязвимость закрывают патчем. Но в AI-платформе одна и та же проблема может лежать в очень разных слоях. В цепочке ML-зависимостей это может быть мажорное обновление фреймворка, в GPU-рантайме — драйвер или прошивка с окном простоя, а в инференс-движке — ожидание исправления от мейнтейнера или замена компонента.
Из-за этого одинаковый CVSS не означает одинаковый приоритет и одинаковый способ устранения. Именно поэтому в статье разбираются восемь публичных CVE из типового AI-стека: для каждой записи нужно отдельно понять, где компонент используется, доступен ли он атакующему, можно ли автоматизировать эксплойт и что именно придётся делать команде, чтобы реально закрыть риск.
Что изменилось для команд и почему это полезно
Проблема старого календарного SLA в том, что он помогал быстро разложить уязвимости по срокам, но плохо учитывал реальный риск. К тому же на него нельзя было полностью опереться: NVD больше не успевает обогащать все CVE, а часть свежих записей может долго оставаться без нужных данных для автоматической приоритизации. Поэтому командам приходится самим проверять, какие версии затронуты, используется ли компонент у них и есть ли компенсирующие меры.
Это полезно не только для AppSec- и DevSecOps-инженеров, но и для тимлидов, у которых релиз завязан на security-тикеты, а также для руководителей ИБ. Для обычной инфраструктуры без GPU и моделей логика та же: важен не только номер CVE, но и то, где стоит компонент, виден ли он снаружи и насколько быстро можно снизить риск без остановки бизнеса.